
Key Takeaways
Podstawy procesu: Zdefiniowany proces elektronicznego ujawniania informacji ma kluczowe znaczenie dla identyfikowania, zabezpieczania i przekazywania dowodów cyfrowych w sprawach prawnych.
Zarządzanie kosztami: Kontrolowanie ilości danych, wczesne mapowanie sprawy i korzystanie z technologii to główne sposoby ograniczania kosztów elektronicznego ujawniania informacji.
Integracja technologii: Nowoczesne procesy elektronicznego ujawniania informacji wykorzystują technologie TAR, analitykę i narzędzia oparte na chmurze, aby usprawnić przegląd, analizę i przekazywanie materiałów.
Koordynacja zespołu: Skuteczne procesy wymagają jasno określonych ról i komunikacji między działami prawnym, IT i operacyjnym oraz zewnętrznymi dostawcami na każdym etapie projektu.
Praktyki zapewniające możliwość obrony procesu: Dokumentowanie każdego etapu i każdej decyzji gwarantuje, że proces elektronicznego ujawniania informacji wytrzyma kontrolę prawną i audyty zgodności.
Przepływ pracy eDiscovery to sposób, w jaki zespoły prawne identyfikują, zabezpieczają, gromadzą, przeglądają i przedstawiają elektronicznie przechowywane informacje na potrzeby postępowań sądowych lub dochodzeń. Bez zdefiniowanego procesu istnieje ryzyko pominięcia danych, luk w możliwości obrony przyjętych działań oraz gwałtownie rosnących kosztów.
Z mojego doświadczenia wynika, że największe zagrożenia wynikają z reaktywnych, doraźnych procesów tworzonych pod presją terminów. Ten przewodnik obejmuje każdy etap — od wstępnej oceny sprawy po przedstawienie materiału dowodowego — a także role zespołu, czynniki wpływające na koszty, najważniejsze technologie i najlepsze praktyki. Odpowiednie oprogramowanie eDiscovery zapewnia rzeczywistą przewagę na niemal każdym etapie.
10 Lista najlepszych przepływów pracy eDiscovery
Czym jest przepływ pracy eDiscovery?
Przepływ pracy eDiscovery to kompleksowy proces, który zespoły prawne stosują w celu identyfikowania, zabezpieczania, gromadzenia, przetwarzania, przeglądania i przedstawiania elektronicznie przechowywanych informacji (ESI) w odpowiedzi na postępowania sądowe, dochodzenia lub żądania organów regulacyjnych. Stanowi on operacyjny fundament każdej sprawy dotyczącej sporu lub zgodności z przepisami, która obejmuje dane cyfrowe.
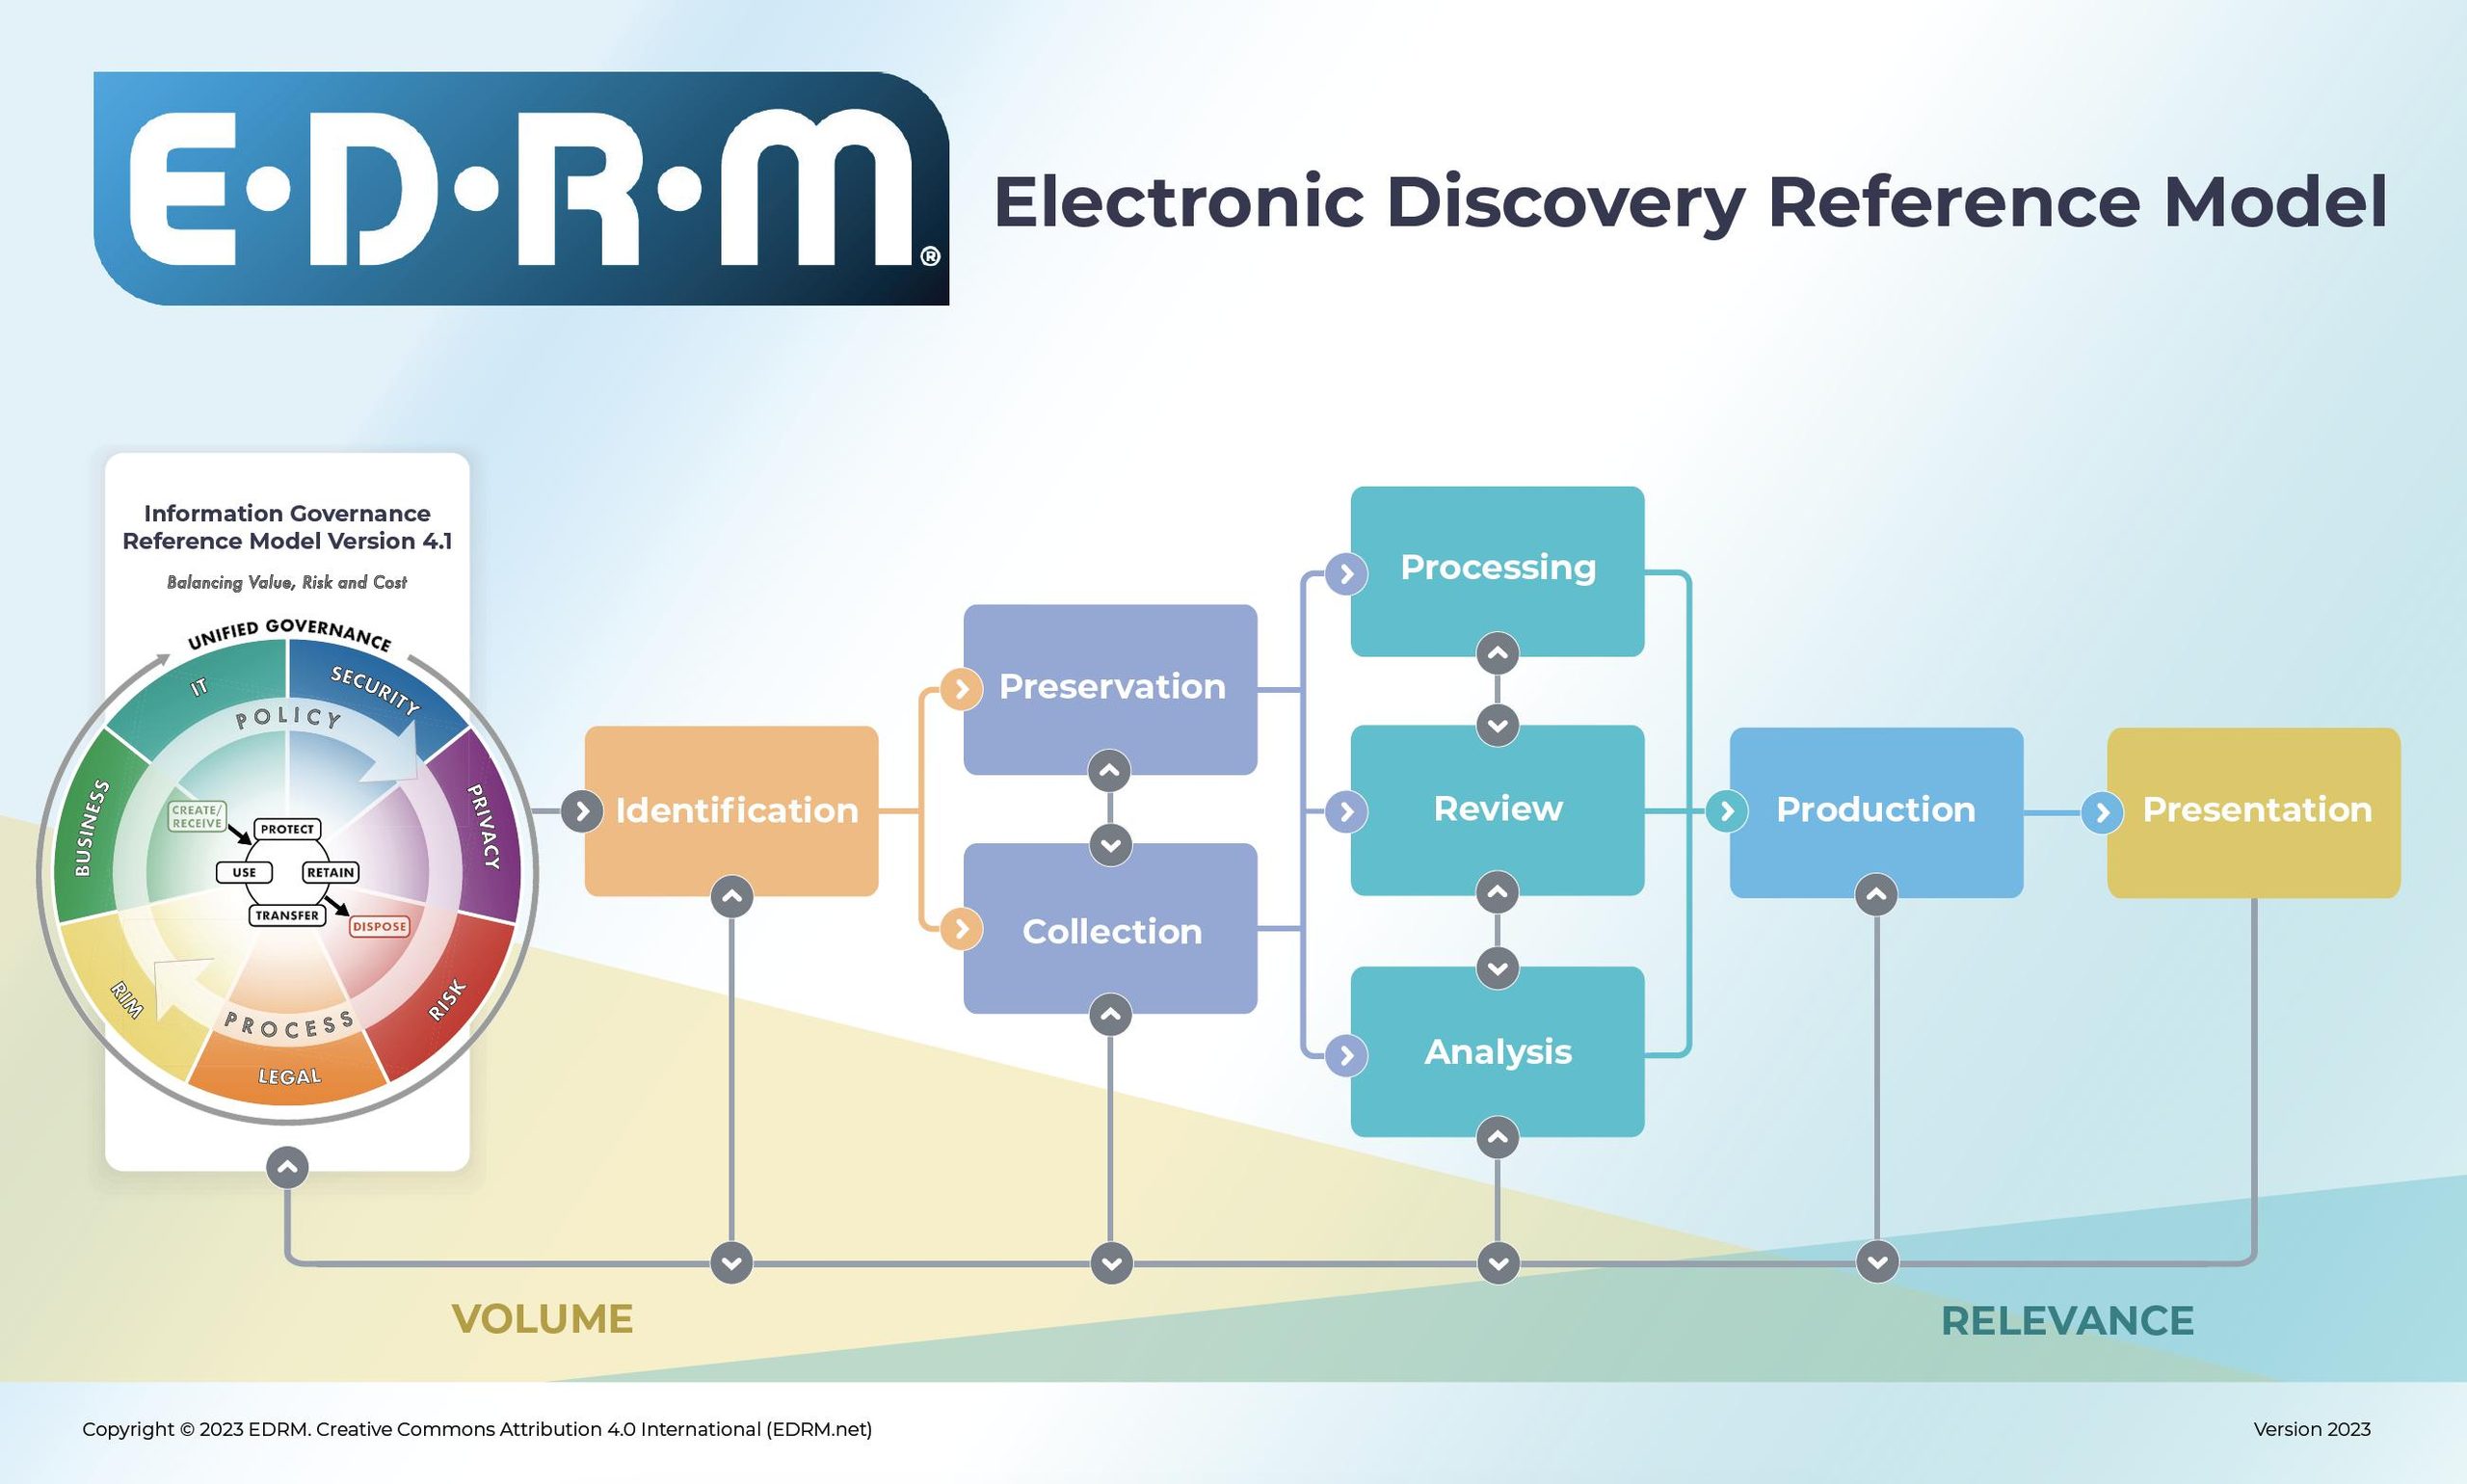
Większość przepływów pracy eDiscovery jest zgodna z modelem referencyjnym odkrywania elektronicznego (EDRM), powszechnie akceptowanymi ramami porządkującymi proces od zarządzania informacjami po końcową prezentację. EDRM nie narzuca oprogramowania ani taktyki — zapewnia wszystkim zainteresowanym stronom wspólny język.
Wyobraź sobie ten przepływ pracy jako lejek. Zaczynasz od potencjalnie ogromnego zbioru ESI pochodzących od opiekunów danych, z systemów i różnych obszarów geograficznych. Każdy etap zawęża ten zbiór — przetwarzanie usuwa pliki systemowe i duplikaty, a przegląd pozwala ustalić, co jest rzeczywiście istotne — aż pozostają wyłącznie dane, które należy przedstawić.
Dlaczego zdefiniowany przepływ pracy eDiscovery ma znaczenie
Zdefiniowany przepływ pracy odróżnia proces, którego można bronić, od kosztownego i chaotycznego postępowania. Bez niego zespoły podejmują decyzje pod presją terminów, pomijają opiekunów danych i narażają się na zarzut zniszczenia lub utraty dowodów.
Sądy oceniają decyzje dotyczące zabezpieczania i gromadzenia danych według kryterium racjonalności, a nie perfekcji. Racjonalność wymaga jednak dokumentacji i spójności. Zgodnie z raportem eDiscovery Assistant dotyczącym orzecznictwa z 2024 r., sankcje pojawiły się wśród kwestii oznaczonych w 1456 decyzjach dotyczących eDiscovery w 2024 r. Nie oznacza to, że sankcje zostały nałożone w każdej sprawie, ale pokazuje, jak często sposób prowadzenia odkrywania elektronicznego staje się przedmiotem sporu. Powtarzalny przepływ pracy zapewnia udokumentowany zapis na wypadek zakwestionowania tych decyzji.
Drugim czynnikiem jest efektywność. Gdy wiadomo, co uruchamia obowiązek zabezpieczenia danych, kto odpowiada za każdy etap oraz jakie narzędzia obsługują przetwarzanie i przegląd, mniej czasu poświęca się na improwizację, a więcej na pracę, która rzeczywiście ma znaczenie.
Najważniejsze etapy przepływu pracy eDiscovery
Poniższe siedem etapów opiera się na głównych działaniach określonych w modelu referencyjnym odkrywania elektronicznego (EDRM), dostosowanym do praktycznego przepływu pracy zespołów prawnych. Wcześniejsze ramy EDRM obejmowały dziewięć etapów, w tym zarządzanie informacjami i prezentację. Działania te nie zostały tu pominięte: zarządzanie informacjami wspiera cały cykl życia odkrywania elektronicznego, natomiast prezentacja zwykle następuje po przedstawieniu materiału dowodowego, podczas rozpraw lub przygotowań do procesu.
Zaktualizowany model EDRM 2.0, opublikowany 1 września 2026 r., kładzie większy nacisk na zarządzanie informacjami, ciągłą analizę i możliwe do obrony dysponowanie danymi. Ten siedmioetapowy przewodnik koncentruje się na działaniach operacyjnych od identyfikacji po przedstawienie materiału dowodowego, zamiast odtwarzać każdy element pełnego modelu.
Etap 1: Identyfikacja i wstępna ocena sprawy
Identyfikacja to etap, na którym określasz zakres sprawy, zanim jakiekolwiek dane zostaną przeniesione. Celem jest uzyskanie odpowiedzi na dwa pytania: jakie dane istnieją i które z nich mogą być istotne?
Ten etap obejmuje zmapowanie źródeł danych — serwerów poczty elektronicznej, pamięci masowej w chmurze, platform do współpracy, urządzeń mobilnych i repozytoriów stron trzecich — oraz wskazanie opiekunów danych, którzy prawdopodobnie posiadają istotne informacje. Równolegle przeprowadza się wstępną ocenę sprawy (ECA), dzięki czemu zespoły prawne mogą ocenić ilość dokumentów, kluczowe zagadnienia i ryzyko przed podjęciem decyzji dotyczącej strategii gromadzenia danych.
Na tym etapie zalecałbym natychmiastowe włączenie działu IT. Zespoły prawne rzadko mają pełny obraz tego, gdzie w organizacji znajdują się ESI. Szybkie zmapowanie danych na wczesnym etapie pozwala uniknąć bolesnego odkrycia zapomnianej witryny SharePoint lub obszaru roboczego Slack trzy miesiące po rozpoczęciu sprawy.
Etap 2: Zabezpieczenie danych i nakaz zachowania danych na potrzeby postępowania
Zabezpieczanie danych rozpoczyna się w chwili, gdy można zasadnie przewidywać wszczęcie postępowania sądowego. Oznacza to zawieszenie rutynowych zasad usuwania danych i wydanie wszystkim właściwym opiekunom danych zawiadomień o obowiązku ich zachowania.
Na mocy FRCP 37(e) sądy mogą nałożyć sankcje, gdy ESI zostaną utracone, ponieważ nie podjęto uzasadnionych działań w celu ich zabezpieczenia. Linia orzecznicza Zubulake przeciwko UBS Warburg ustanowiła obecnie obowiązujący standard: wydawać nakazy zachowania danych niezwłocznie, potwierdzać ich otrzymanie i ponawiać kontakt w przypadku braku odpowiedzi.
Zawiadomienia o obowiązku zachowania danych powinny być dokumentowane i monitorowane. Potwierdzenia otrzymania przez opiekunów danych mają znaczenie — jeśli nakaz zostanie zakwestionowany, warto dysponować dokumentacją potwierdzającą, że został wydany i zaakceptowany. W każdej sprawie obejmującej więcej niż kilku opiekunów danych warto zainwestować w oprogramowanie do zarządzania nakazami zachowania danych, które automatyzuje przypomnienia i rejestruje odpowiedzi.
Etap 3: Gromadzenie danych
Gromadzenie danych to proces pozyskiwania ESI ze zidentyfikowanych źródeł w sposób zgodny z zasadami informatyki śledczej. Sposób postępowania zależy od złożoności sprawy i rodzaju danych.
W przypadku postępowań sądowych o wysokiej stawce gromadzenie danych metodami informatyki śledczej zachowuje metadane i zapewnia utrzymanie łańcucha nadzoru nad dowodem — jest to wymóg umożliwiający obronę prawidłowości postępowania, jeśli autentyczność zostanie później zakwestionowana. W mniejszych sprawach dopuszczalne może być ukierunkowane samodzielne gromadzenie danych przez opiekunów, choć wiąże się ono z większym ryzykiem niepełnych lub niespójnych wyników.
Mary Mack wyjaśnia, że przenoszenie plików elektronicznych między urządzeniami może zmienić istotne metadane, w tym daty utworzenia i informacje o właścicielu. Nawet niewielkie zmiany mogą rodzić pytania dotyczące autentyczności dowodu i łańcucha nadzoru nad nim.
Ten drobny problem może przerodzić się w poważne ryzyko prawne podczas uwierzytelniania łańcucha nadzoru nad dowodem w sądzie.
Platformy chmurowe zwiększają złożoność procesu. Gromadzenie danych z Microsoft 365, Google Workspace, Slack lub Salesforce wymaga konektorów dostosowanych do poszczególnych platform oraz wiedzy o tym, jakie dane każdy z tych systemów domyślnie przechowuje. Przed przeniesieniem danych należy znać swoje źródła — to kolejny powód, dla którego wczesna identyfikacja przynosi korzyści.
Etap 4: Przetwarzanie, usuwanie duplikatów i filtrowanie plików systemowych
Przetwarzanie przekształca surowe zgromadzone dane do formatu umożliwiającego ich przeglądanie i zmniejsza ich ilość poprzez selekcję. Bezpośrednio wpływa ono na ilość danych, które zespół dokonujący przeglądu musi przeanalizować.
Podstawowe zadania związane z przetwarzaniem to:
- Usuwanie duplikatów: Usuwanie identycznych lub niemal identycznych dokumentów u różnych opiekunów danych, aby osoby dokonujące przeglądu nie czytały wielokrotnie tego samego łańcucha wiadomości e-mail.
- Filtrowanie plików NIST: Odfiltrowywanie znanych plików systemowych z użyciem referencyjnego zestawu danych National Institute of Standards and Technology (NIST). Pliki systemu operacyjnego i pliki wykonywalne oprogramowania nie stanowią dowodów — filtrowanie plików NIST usuwa je automatycznie.
- Ekstrakcja metadanych: Pobieranie daty, autora, typu pliku i danych opiekuna na potrzeby przeglądu i przedstawienia materiału dowodowego.
- Normalizacja formatu: Konwertowanie plików w formacie natywnym do standardowego, indeksowalnego formatu — często TIFF lub przeszukiwalnego pliku PDF.
Agresywna, lecz możliwa do uzasadnienia selekcja na tym etapie jest jednym z najbardziej bezpośrednich sposobów kontrolowania późniejszych kosztów przeglądu.
Etap 5: Przegląd i oznaczanie objęcia tajemnicą zawodową
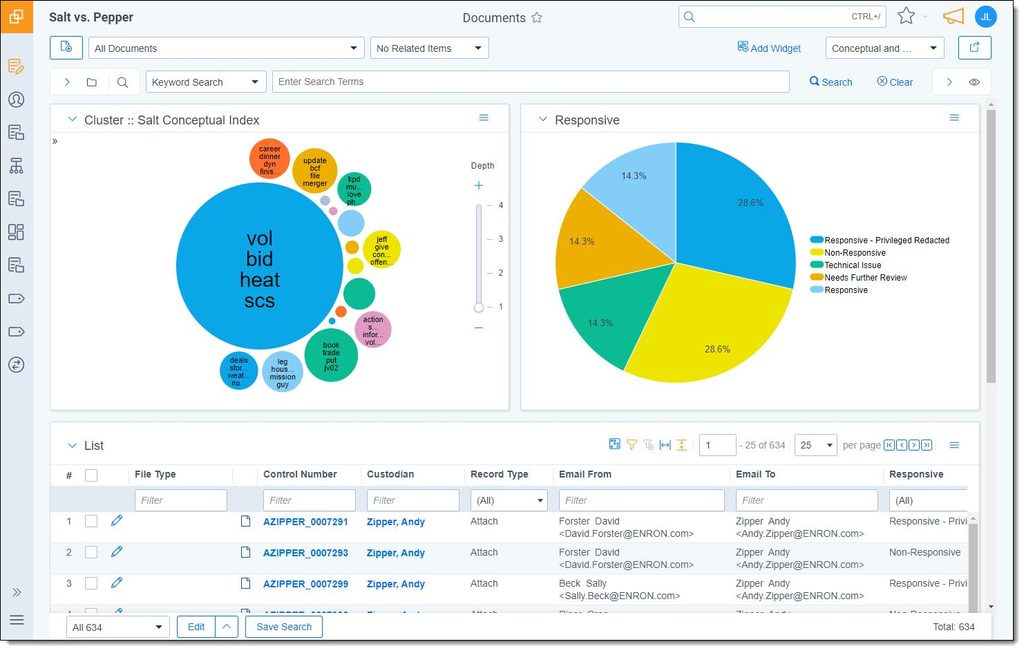
Przegląd dokumentów to etap, na którym prawnicy oceniają każdy dokument pod kątem istotności, związku z żądaniem udostępnienia oraz objęcia tajemnicą zawodową. Historycznie jest to najdroższa część procesu — i ta, na którą technologia wywarła największy wpływ.
Według analizy EDRM dotyczącej wydatków na zadania eDiscovery przegląd dokumentów stanowił 64% wydatków na eDiscovery w 2024 roku. Przewiduje się, że udział ten zmaleje, ponieważ wspomagany technologicznie przegląd (TAR) będzie obsługiwał większą część pracy wykonywanej podczas pierwszego przeglądu. TAR, nazywany również kodowaniem predykcyjnym, wykorzystuje dokumenty przejrzane przez człowieka, aby pomóc przewidzieć istotność w szerszym zbiorze danych. Ciągłe aktywne uczenie (CAL) aktualizuje swój model w miarę kodowania kolejnych dokumentów przez recenzentów, dzięki czemu jest szczególnie przydatne w przypadku dużych lub zmieniających się zbiorów danych.
W przypadku przeglądu pod kątem przywileju każdy dokument potencjalnie chroniony przywilejem adwokat–klient lub doktryną produktu pracy musi zostać oznaczony i zarejestrowany. Błędy dotyczące przywileju na tym etapie niosą ze sobą poważne konsekwencje — należy oznaczać dokumenty szeroko i później doprecyzowywać, zamiast kodować je zbyt wąsko.
Etap 6: Analiza i strategia sprawy
Analiza koncentruje się na wzorcach w całym zbiorze danych, a nie na pojedynczych dokumentach. To etap, na którym zespół przechodzi od pytania „co mówi ten dokument” do pytania „co ten zbiór danych mówi nam o sprawie”.
Terminy wyszukiwania mogą być bardzo przydatne podczas wstępnej selekcji, ale wszyscy wiemy, że nie są doskonałe.”
Narzędzia analityczne wspierają odtwarzanie osi czasu, grupowanie pojęciowe, tworzenie wątków wiadomości e-mail oraz analizę komunikacji. Możliwości te pomagają zidentyfikować kluczowe relacje między opiekunami danych, wykryć luki w materiale dowodowym i ujawnić dokumenty o wysokiej wartości, zanim pojawią się one w materiale przedstawionym przez pełnomocnika strony przeciwnej.
Z mojego doświadczenia wynika, że ten etap jest wykorzystywany w niewystarczającym stopniu. Zespoły traktują analizę jako dodatek po przeglądzie, a nie jako zintegrowaną część procesu. Przeprowadzenie analizy wcześniej — równolegle z przeglądem linearnym lub nawet przed nim — może zmienić kolejność priorytetów dotyczących dokumentów oraz sposób budowania narracji sprawy.
Etap 7: Przygotowanie i dostarczenie materiału
Przygotowanie materiału polega na dostarczeniu pełnomocnikowi strony przeciwnej, organom regulacyjnym lub sądowi przejrzanych, istotnych i nieobjętych przywilejem dokumentów. Właściwy format jest równie ważny jak właściwy dobór dokumentów.
Specyfikacje dotyczące materiału zazwyczaj obejmują:
- Format: obrazy TIFF z wyodrębnionym tekstem, pliki w formacie natywnym lub PDF — często określone nakazem sądowym albo uzgodnionym protokołem.
- Pola metadanych: pola dołączane do materiału, w tym opiekun danych, data, ścieżka pliku i typ pliku.
- Numeracja Bates: sekwencyjne identyfikatory dokumentów stosowane jako odniesienia w zeznaniach i pismach procesowych.
- Pliki ładowania: ustrukturyzowane pliki (DAT, OPT), które umożliwiają stronie odbierającej zaimportowanie materiału do używanej przez nią platformy przeglądowej.
- Rejestr dokumentów objętych przywilejem: rejestr materiałów nieudostępnionych, prowadzony dla każdego dokumentu, obejmujący datę, autora, odbiorcę i podstawę odmowy udostępnienia.
Przed sfinalizowaniem procedury przetwarzania potwierdź specyfikacje dotyczące materiału. Późniejsze formatowanie dużego zbioru materiałów jest kosztowne i można go uniknąć.
Kluczowe technologie napędzające nowoczesne procesy eDiscovery
Technologia nie zastępuje osądu w eDiscovery — zmniejsza ilość danych i pracy, którymi zespół musi zarządzać na każdym etapie. Oto narzędzia, które mają największe znaczenie:
- TAR i CAL: TAR 1.0 wykorzystuje zakodowany przez człowieka zestaw początkowy do trenowania modelu, podczas gdy TAR 2.0 (CAL) nieustannie aktualizuje model w miarę kodowania przez recenzentów kolejnych dokumentów. Podejścia te pomagają zespołom prawnym nadawać priorytet istotnym informacjom i efektywniej zarządzać dużymi zbiorami dokumentów.
- Generatywna sztuczna inteligencja: Narzędzia GenAI wspierają podsumowywanie dokumentów, oznaczanie zagadnień i klasyfikowanie informacji objętych tajemnicą zawodową. Zgodnie z zimowym badaniem cen eDiscovery 2026, $0.26–$0.50 za dokument było najczęściej wskazywanym przedziałem cenowym za przegląd wspomagany przez GenAI wśród respondentów, którzy podali stawki za dokument. Modele cenowe są zróżnicowane, a zespoły prawne nadal muszą ocenić ryzyko halucynacji, możliwość przeprowadzenia audytu i wymagania dotyczące walidacji przed wdrożeniem.
- Analityka: Grupowanie pojęciowe, łączenie wątków wiadomości e-mail i mapowanie komunikacji pomagają zespołom ustalać priorytety dokumentów oraz odtwarzać chronologię wydarzeń bez konieczności ręcznego czytania wszystkiego.
- Platformy chmurowe: Natywne narzędzia eDiscovery działające w chmurze oferują szybsze przetwarzanie, elastyczne skalowanie i bardziej przewidywalne ceny niż systemy lokalne. Warto szukać platform, które integrują gromadzenie, przetwarzanie, przegląd i przygotowanie materiałów do przekazania w jednym środowisku.
- Oprogramowanie do zarządzania obowiązkiem zabezpieczenia dowodów: Automatyzuje powiadomienia dla opiekunów danych, śledzi potwierdzenia i tworzy ścieżkę audytu. W każdej sprawie obejmującej wielu opiekunów danych jest to niezbędny element zapewniający możliwość obrony procesu, a nie tylko mile widziane udogodnienie.
Role i obowiązki zespołu w całym przebiegu procesu
eDiscovery wymaga ścisłej koordynacji między działami prawnym, IT i operacyjnym. To właśnie luki w zakresie odpowiedzialności prowadzą do problemów. Użyj tej tabeli, aby określić, kto kieruje poszczególnymi etapami i kto zapewnia wsparcie:
| Etap | Prowadzą | Wspierają |
|---|---|---|
| EtapIdentyfikacja / ECA | ProwadząPrawnicy wewnętrzni, operacje prawne | WspierająIT, zarządzanie dokumentacją |
| EtapZabezpieczenie / obowiązek zabezpieczenia dowodów | ProwadząPrawnicy wewnętrzni | WspierająOperacje prawne, IT, pomocniczy pracownicy działu prawnego |
| EtapGromadzenie | ProwadząIT, dostawca eDiscovery | WspierająPrawnicy wewnętrzni, operacje prawne |
| EtapPrzetwarzanie | ProwadząDostawca eDiscovery | WspierająIT |
| EtapPrzegląd | ProwadząPrawnicy zewnętrzni, prawnicy kontraktowi | WspierająOperacje prawne, pomocniczy pracownicy działu prawnego |
| EtapAnaliza | ProwadząPrawnicy zewnętrzni, operacje prawne | WspierająDostawca eDiscovery |
| EtapPrzekazanie materiałów | ProwadząPrawnicy zewnętrzni, dostawca eDiscovery | WspierająOperacje prawne, IT |
Na podstawie doświadczenia dodałbym jeszcze kilka kwestii:
- Operacje prawne często pełnią funkcję warstwy koordynacyjnej między działem prawnym a IT. W większych sprawach wyznaczenie jednej osoby kontaktowej z zespołu operacji prawnych zapobiega opóźnieniom w punktach przekazywania zadań.
- IT często nie ma wglądu w działania działu prawnego aż do momentu otrzymania żądania gromadzenia danych. Włączenie IT do procesu identyfikacji — zanim jakiekolwiek dane zostaną przeniesione — pozwala uniknąć działań podejmowanych w ostatniej chwili.
- Dostawcy znacznie różnią się zakresem usług. Niektórzy zapewniają kompleksowo zarządzany przegląd, inni zajmują się wyłącznie przetwarzaniem i hostingiem. Zanim sprawa się rozpocznie, upewnij się, co dokładnie kupujesz.
More Articles
Czynniki kosztowe w przebiegu procesu eDiscovery i sposoby ich kontrolowania
Największym czynnikiem wpływającym na koszty eDiscovery jest ilość danych. Im mniej danych przechodzi przez proces, tym mniej wydajesz na każdym kolejnym etapie. Oto najważniejsze czynniki kosztowe i obszary, w których można ograniczyć wydatki:
- Zakres gromadzenia: Szerokie listy opiekunów danych i gromadzenie całej zawartości skrzynek podnoszą koszty na wszystkich kolejnych etapach. Ukierunkowane gromadzenie — ograniczone zakresem dat, typem plików i słowami kluczowymi — zmniejsza ilość danych bez uszczerbku dla możliwości obrony procesu.
- Opłaty za przetwarzanie: Przetwarzanie może kosztować około $25–$100 za GB, w zależności od ilości danych, umów z dostawcą i wymagań dotyczących przetwarzania. Zgodnie z przewodnikiem cenowym eDiscovery Insider, konkurencyjne stawki za przetwarzanie zwykle mieszczą się w przedziale od $50 do $100 za GB, natomiast w przypadku dużych wolumenów mogą być niższe. Usuwanie duplikatów i danych niebędących dokumentami zgodnie ze standardem NIST pomagają zmniejszyć ilość danych, które trzeba hostować i przeglądać.
- Opłaty za hosting: Miesięczne opłaty naliczane za GB szybko się kumulują w przypadku długotrwałych spraw. Z góry negocjuj stałą opłatę lub cenę obejmującą wszystkie usługi i potwierdź, czy usuwanie duplikatów odbywa się przed obliczeniem kosztów hostingu.
- Praca związana z przeglądem: Przegląd wykonywany przez prawników i ocena informacji objętych tajemnicą zawodową mogą generować znaczne koszty eDiscovery, szczególnie gdy duże ilości dokumentów wymagają ręcznego badania. Wykorzystanie TAR lub zwalidowanego przeglądu pierwszego etapu wspomaganego przez GenAI może zmniejszyć nakład pracy i pomóc zespołom nadać priorytet dokumentom wymagającym dokładniejszego zbadania.
- Zmiany formatu na późnym etapie: Wczesne uzgodnienie specyfikacji przekazania materiałów pozwala uniknąć kosztownego ponownego formatowania. Wymagania dotyczące formatu uwzględnij w planie gromadzenia i przetwarzania od samego początku.
Zachęcałbym każdy zespół do śledzenia wydatków według etapów w poszczególnych sprawach. Bez danych bazowych pokazujących, na co faktycznie przeznaczane są pieniądze, trudno negocjować lepsze ceny lub uzasadnić inwestycje w technologię.
Najlepsze praktyki dotyczące możliwego do obrony i powtarzalnego przepływu pracy w zakresie elektronicznego postępowania dowodowego
Możliwy do obrony przepływ pracy nie polega wyłącznie na podejmowaniu właściwych działań — chodzi również o możliwość wykazania, że zostały one podjęte. Praktyki te sprawiają, że proces jest zarówno rzetelny, jak i możliwy do udokumentowania:
- Przed każdą sprawą sporządź mapę danych: Ustal, gdzie znajdują się ESI, kto sprawuje nad nimi kontrolę i jakie obowiązują zasady przechowywania. Dzięki temu identyfikacja przebiega szybciej, a zabezpieczenia są pełniejsze.
- Niezwłocznie wydawaj nakazy zabezpieczenia i śledź potwierdzenia: Nie polegaj na nieformalnej komunikacji. Korzystaj z oprogramowania do zarządzania zabezpieczeniami lub co najmniej z monitorowanej wiadomości e-mail wymagającej odpowiedzi. Dokumentuj wszystko.
- Określaj zakres proporcjonalnie: Współpracuj z pełnomocnikiem przy ustalaniu parametrów gromadzenia danych zgodnie z FRCP 26(b)(1). Proporcjonalność jest uznanym standardem — wykorzystaj ją, aby sprzeciwić się żądaniom o zbyt szerokim zakresie.
- Dokumentuj każdą decyzję dotyczącą przetwarzania: Filtry usuwające dane nieistotne według NIST, ograniczenia zakresu dat, logika terminów wyszukiwania — wszystko powinno być rejestrowane i przechowywane. Jeśli zakwestionowany zostanie Twój proces, dokumentacja będzie Twoją obroną.
- Weryfikuj TAR przed zakończeniem przeglądu: Zanim wykorzystasz kodowanie predykcyjne do zamknięcia zbioru dokumentów, przeprowadź statystycznie prawidłową próbę kontroli jakości, aby potwierdzić, że kompletność i precyzja spełniają uzgodnione wartości progowe.
- Uzgadniaj specyfikacje produkcji na piśmie: Przed przekazaniem jakichkolwiek materiałów uzyskaj wspólne porozumienie procesowe lub postanowienie sądu obejmujące format, pola metadanych i wymagania dotyczące rejestru informacji objętych tajemnicą zawodową.
- Przeprowadzaj przeglądy po zakończeniu sprawy: Po zamknięciu każdej sprawy omów jej przebieg z zespołem. Gdzie koszty gwałtownie wzrosły? Co trwało dłużej, niż oczekiwano? Wykorzystaj te ustalenia w kolejnym przepływie pracy.
Powtarzalność nie oznacza sztywności. Przepływ pracy powinien być wystarczająco szczegółowo udokumentowany, aby można go było bronić, i jednocześnie na tyle elastyczny, aby dostosowywał się do rodzajów danych oraz złożoności każdej sprawy.
Znajdź odpowiednie oprogramowanie do elektronicznego postępowania dowodowego dla swojego przepływu pracy
Możliwy do obrony przepływ pracy w zakresie elektronicznego postępowania dowodowego zależy od posiadania odpowiednich narzędzi do zarządzania zabezpieczeniem, gromadzeniem, przetwarzaniem, przeglądem i produkcją danych. Zapoznaj się z moim przewodnikiem po najlepszym oprogramowaniu do elektronicznego postępowania dowodowego, aby porównać platformy, ocenić ich możliwości i znaleźć rozwiązanie odpowiadające potrzebom Twojego zespołu prawnego.