Key Takeaways
Principes essentiels du flux de travail: Un flux de travail défini pour la découverte électronique est essentiel pour identifier, préserver et produire les preuves numériques dans les affaires judiciaires.
Gestion des coûts: La maîtrise du volume de données, la cartographie précoce de l'affaire et l'utilisation de la technologie sont les principaux leviers pour réduire les dépenses liées à la découverte électronique.
Intégration technologique: Les flux de travail modernes de découverte électronique tirent parti de l'examen assisté par la technologie, de l'analyse et des outils en ligne pour rationaliser l'examen, l'analyse et la communication des éléments.
Coordination de l'équipe: Des flux de travail efficaces nécessitent des rôles clairement définis et une communication entre les équipes juridiques, informatiques et opérationnelles, ainsi qu'avec les prestataires externes, à chaque étape du projet.
Pratiques garantissant la défendabilité: La documentation de chaque étape et de chaque décision garantit que votre flux de travail de découverte électronique résistera à l'examen juridique et aux audits de conformité.
Un flux de travail d’eDiscovery décrit la manière dont les équipes juridiques identifient, préservent, collectent, examinent et produisent les informations stockées électroniquement dans le cadre d’un litige ou d’une enquête. Sans processus défini, vous vous exposez à des données manquées, à des lacunes en matière de défendabilité et à des coûts qui s’envolent rapidement.
D’après mon expérience, les principaux risques proviennent de processus réactifs et ponctuels mis en place sous la pression des délais. Ce guide couvre chaque étape, de l’évaluation précoce du dossier à la production, ainsi que les rôles de l’équipe, les facteurs de coût, les technologies clés et les bonnes pratiques. Le bon logiciel d’eDiscovery vous donne un réel avantage à presque chaque étape.
10 Sélection des meilleurs flux de travail d’eDiscovery
Here's my pick of the 10 best software from the 10 tools reviewed.
Les clics sur les liens ci-dessous peuvent générer une commission qui soutient nos tests indépendants et l’évaluation des logiciels et services. En savoir plus sur notre démarche de transparence.
Qu’est-ce qu’un flux de travail d’eDiscovery ?
Un flux de travail d’eDiscovery est le processus de bout en bout que suivent les équipes juridiques pour identifier, préserver, collecter, traiter, examiner et produire les informations stockées électroniquement (ESI) en réponse à un litige, à une enquête ou à une demande réglementaire. Il constitue la colonne vertébrale opérationnelle de toute affaire contentieuse ou de conformité impliquant des données numériques.
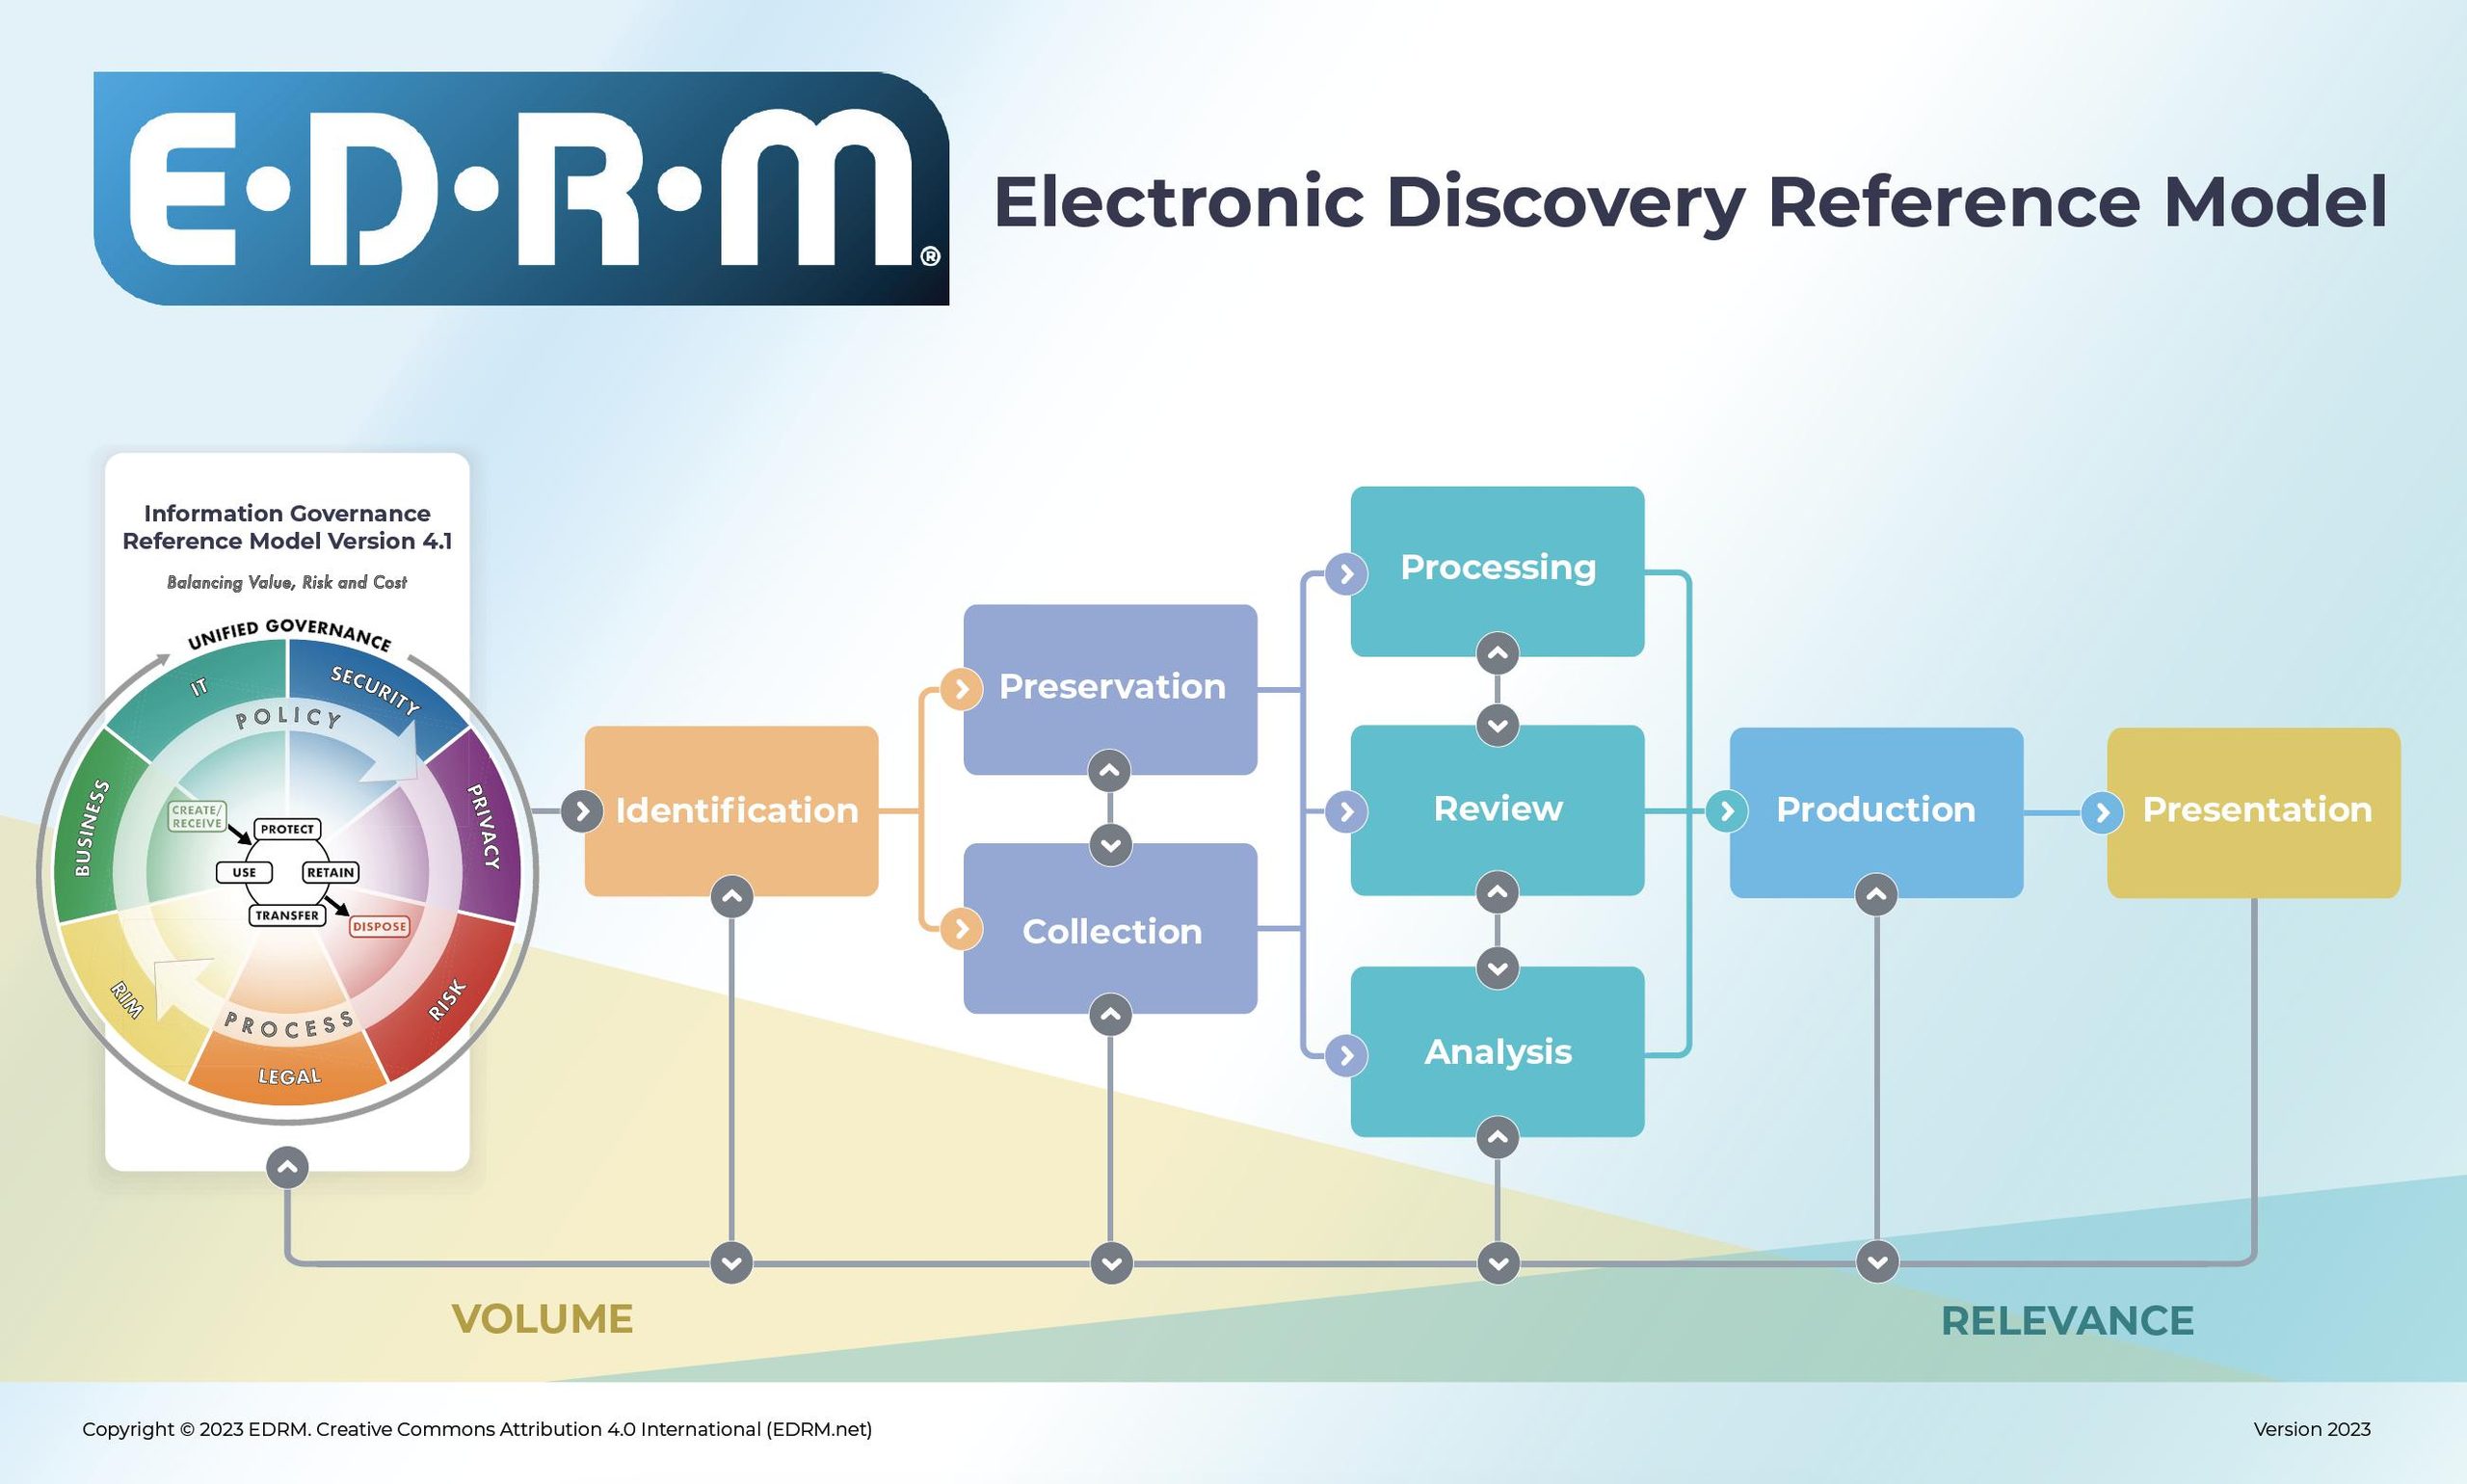
La plupart des flux de travail d’eDiscovery s’alignent sur le modèle de référence de la découverte électronique (EDRM), un cadre largement reconnu qui ordonne le processus, de la gouvernance de l’information à la présentation finale. L’EDRM ne prescrit ni logiciels ni tactiques : il fournit à toutes les parties prenantes un vocabulaire commun.
Imaginez ce flux de travail comme un entonnoir. Vous commencez avec un ensemble potentiellement immense d’ESI réparties entre différents dépositaires, systèmes et zones géographiques. Chaque étape réduit cet ensemble : le traitement supprime les fichiers système et les doublons, tandis que l’examen identifie les éléments réellement pertinents, jusqu’à ce qu’il ne reste que ce qui doit être produit.
Pourquoi un flux de travail d’eDiscovery défini est-il important ?
Un flux de travail défini est ce qui distingue un processus défendable d’un processus coûteux et chaotique. Sans lui, les équipes prennent des décisions sous la pression des délais, oublient certains dépositaires et laissent subsister un risque de destruction ou d’altération des preuves.
Les tribunaux évaluent les décisions de préservation et de collecte selon un critère de caractère raisonnable, et non de perfection. Mais le caractère raisonnable exige de la documentation et de la cohérence. Selon le rapport 2024 de jurisprudence d’eDiscovery Assistant, des sanctions figuraient parmi les questions relevées dans 1 456 décisions d’eDiscovery en 2024. Cela ne signifie pas que des sanctions ont été prononcées dans chaque affaire, mais souligne à quelle fréquence la conduite en matière de découverte devient contestée. Un flux de travail reproductible fournit un historique documenté lorsque ces décisions sont contestées.
L’efficacité est l’autre facteur déterminant. Lorsque vous savez ce qui déclenche une obligation de conservation, qui est responsable de chaque étape et quels outils prennent en charge le traitement et l’examen, vous consacrez moins de temps à improviser et davantage à un travail réellement utile.
Les étapes clés du flux de travail d’eDiscovery
Les sept étapes ci-dessous suivent les activités essentielles du modèle de référence de la découverte électronique (EDRM), adaptées en un flux de travail pratique pour les équipes juridiques. Le cadre EDRM initial comprenait neuf étapes, dont la gouvernance de l’information et la présentation. Ces activités ne sont pas exclues ici : la gouvernance de l’information soutient l’ensemble du cycle de vie de la découverte, tandis que la présentation intervient généralement après la production, lors des audiences ou de la préparation du procès.
L’EDRM 2.0 mis à jour, publié le 1er septembre 2026, accorde une plus grande importance à la gouvernance de l’information, à l’analyse continue et à la mise au rebut défendable. Ce guide en sept étapes se concentre sur les étapes opérationnelles allant de l’identification à la production, plutôt que de reproduire chaque composante du modèle complet.
Étape 1 : identification et évaluation précoce du dossier
L’identification est l’étape au cours de laquelle vous définissez le périmètre de l’affaire avant tout déplacement de données. L’objectif est de répondre à deux questions : quelles données existent et lesquelles sont potentiellement pertinentes ?
Cette étape consiste à cartographier les sources de données — serveurs de messagerie, espaces de stockage en nuage, plateformes de collaboration, appareils mobiles et référentiels tiers — et à identifier les dépositaires susceptibles de détenir des informations pertinentes. L’évaluation précoce du dossier (ECA) se déroule en parallèle, ce qui permet aux équipes juridiques d’évaluer le volume de documents, les thèmes clés et les risques avant de s’engager dans une stratégie de collecte.
Je recommande d’impliquer immédiatement le service informatique à ce stade. Les équipes juridiques ont rarement une vision complète de l’emplacement des ESI dans l’organisation. Une cartographie rapide des données dès le début évite la découverte pénible, trois mois après le début du dossier, d’un site SharePoint ou d’un espace de travail Slack oublié.
Étape 2 : Conservation et obligation de conservation juridique
La conservation entre en vigueur dès que le litige devient raisonnablement prévisible. Cela signifie suspendre les politiques de suppression habituelles et envoyer des avis d’obligation de conservation juridique à tous les dépositaires concernés.
En vertu de la règle 37(e) des FRCP, les tribunaux peuvent imposer des sanctions lorsque des ESI sont perdues parce que des mesures raisonnables n’ont pas été prises pour les conserver. La jurisprudence issue de l’affaire Zubulake v. UBS Warburg a établi l’attente actuelle : émettre rapidement les obligations de conservation, en confirmer la réception et effectuer un suivi en cas de non-réponse.
Les avis d’obligation de conservation doivent être documentés et suivis. Les accusés de réception des dépositaires sont importants : si une obligation de conservation est contestée, vous devez pouvoir produire un dossier montrant qu’elle a été émise et confirmée. Pour tout dossier impliquant plus de quelques dépositaires, un logiciel de gestion des obligations de conservation qui automatise les rappels et consigne les réponses justifie l’investissement.
Étape 3 : Collecte
La collecte est le processus consistant à rassembler les ESI provenant de sources identifiées d’une manière conforme aux exigences de l’informatique légale. La méthode dépend de la complexité du dossier et des types de données concernés.
Pour les litiges à forts enjeux, la collecte informatique légale préserve les métadonnées et maintient la chaîne de possession — une exigence de défendabilité si l’authenticité est contestée ultérieurement. Pour les dossiers moins importants, l’auto-collecte ciblée par les dépositaires peut être acceptable, bien qu’elle comporte un risque plus élevé de résultats incomplets ou incohérents.
Mary Mack explique que le déplacement de fichiers électroniques entre appareils peut modifier des métadonnées importantes, notamment les dates de création et les informations relatives à la propriété. Même de petites modifications peuvent soulever des questions concernant l’authenticité des preuves et leur chaîne de possession.
Ce problème mineur peut devenir un risque juridique majeur lors de l’authentification de la chaîne de possession devant un tribunal.
Les plateformes en nuage ajoutent de la complexité. La collecte depuis Microsoft 365, Google Workspace, Slack ou Salesforce nécessite des connecteurs propres à chaque plateforme et une compréhension de ce que chaque système conserve par défaut. Identifiez vos sources avant le déplacement des données — une raison supplémentaire pour laquelle une identification précoce est payante.
Étape 4 : Traitement, déduplication et filtrage NIST
Le traitement convertit les données brutes collectées dans un format pouvant être examiné et réduit le volume par élimination. Il détermine directement la quantité de données que votre équipe d’examen devra traiter.
Les principales tâches de traitement sont les suivantes :
- Déduplication : Suppression des documents exactement ou presque identiques entre les dépositaires afin que les examinateurs ne lisent pas plusieurs fois la même chaîne d’e-mails.
- Filtrage NIST : Filtrage des fichiers système connus à l’aide de l’ensemble de données de référence de l’Institut national des normes et de la technologie (NIST). Les fichiers du système d’exploitation et les exécutables logiciels ne constituent pas des preuves ; le filtrage NIST les supprime automatiquement.
- Extraction des métadonnées : Extraction de la date, de l’auteur, du type de fichier et des données relatives au dépositaire pour leur utilisation lors de l’examen et de la production.
- Normalisation des formats : Conversion des fichiers natifs dans un format standard et indexable — souvent TIFF ou PDF interrogeable.
Une élimination rigoureuse mais défendable à ce stade constitue l’un des moyens les plus directs de maîtriser les coûts d’examen ultérieurs.
Étape 5 : Examen et codage du privilège juridique
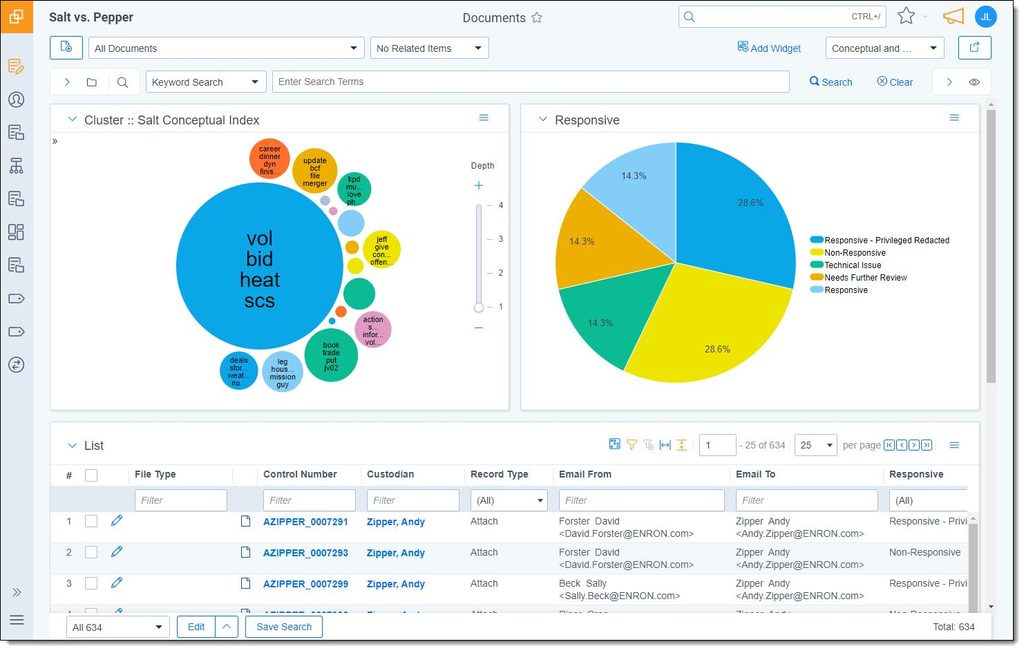
L’examen des documents est l’étape au cours de laquelle les avocats évaluent la pertinence, le caractère communicable et le privilège juridique de chaque document. Il s’agit historiquement de la partie la plus coûteuse du processus — et de celle qui a été le plus transformée par la technologie.
Selon l’analyse de l’EDRM sur les dépenses liées aux tâches d’eDiscovery, l’examen des documents représentait 64 % des dépenses d’eDiscovery en 2024. Cette part devrait diminuer à mesure que l’examen assisté par la technologie (TAR) prendra en charge une plus grande partie du travail de première passe. Également appelé codage prédictif, le TAR utilise des documents examinés par des humains pour contribuer à prédire la pertinence sur un ensemble de données plus vaste. L’apprentissage actif continu (CAL) met à jour son modèle à mesure que les examinateurs codent des documents supplémentaires, ce qui le rend particulièrement utile pour les ensembles de données volumineux ou évolutifs.
Lors de l’examen des documents protégés, tout document potentiellement couvert par le secret professionnel entre l’avocat et son client ou par la doctrine du produit du travail doit être signalé et consigné. Les erreurs relatives au secret professionnel à ce stade peuvent avoir de graves conséquences : il vaut mieux signaler largement les documents et affiner ensuite que les coder de manière trop restrictive.
Étape 6 : Analyse et stratégie du dossier
L’analyse porte sur les tendances qui se dégagent des données plutôt que sur les documents pris individuellement. C’est à ce stade que l’équipe passe de « que dit ce document ? » à « que nous apprennent ces données sur le dossier ? »
Les termes de recherche peuvent être très utiles pour effectuer un premier tri, mais nous savons tous qu’ils sont imparfaits.”
Les outils d’analyse permettent de reconstituer une chronologie, de regrouper les concepts, d’organiser les fils de discussion des e-mails et d’analyser les communications. Ces fonctionnalités vous aident à identifier les principales relations entre les dépositaires, à repérer les lacunes dans les éléments du dossier et à faire émerger les documents à forte valeur avant qu’ils ne figurent dans la production de la partie adverse.
D’après mon expérience, cette étape est sous-exploitée. Les équipes considèrent l’analyse comme un complément ajouté après l’examen, plutôt que comme une partie intégrée du processus. Effectuer l’analyse plus tôt — parallèlement à l’examen linéaire, voire avant celui-ci — peut modifier les documents que vous mettez en priorité et la manière dont vous construisez le récit du dossier.
Étape 7 : Production et remise
La production consiste à remettre à l’avocat de la partie adverse, aux autorités de réglementation ou au tribunal les documents examinés, pertinents et non couverts par le secret professionnel. Il est aussi important de choisir le bon format que de sélectionner les bons documents.
Les spécifications de production couvrent généralement :
- Format : images TIFF avec texte extrait, fichiers natifs ou PDF — souvent déterminé par une ordonnance du tribunal ou un protocole convenu.
- Champs de métadonnées : les champs qui accompagnent la production, notamment le dépositaire, la date, le chemin d’accès au fichier et le type de fichier.
- Numérotation Bates : identifiants de documents séquentiels appliqués pour référence lors des dépositions et dans les actes de procédure.
- Fichiers de chargement : fichiers structurés (DAT, OPT) qui permettent à la partie destinataire d’importer la production dans sa plateforme d’examen.
- Registre des documents couverts par le secret professionnel : registre document par document des éléments retenus, indiquant notamment la date, l’auteur, le destinataire et le motif de la rétention.
Confirmez les spécifications de production avant de finaliser votre flux de traitement. Reformater rétroactivement une production volumineuse coûte cher et peut être évité.
Les technologies clés qui alimentent les flux de travail modernes d’eDiscovery
La technologie ne remplace pas le jugement dans l’eDiscovery : elle réduit le volume de données et de travail que votre équipe doit gérer à chaque étape. Voici les outils qui ont le plus d’impact :
- TAR et CAL : TAR 1.0 utilise un ensemble de données d'amorçage codé par des humains pour entraîner un modèle, tandis que TAR 2.0 (CAL) met continuellement à jour le modèle à mesure que les évaluateurs codent des documents supplémentaires. Ces approches aident les équipes juridiques à hiérarchiser les informations pertinentes et à gérer plus efficacement de grands ensembles de documents.
- IA générative : Les outils d'IA générative prennent en charge la synthèse de documents, l'étiquetage des questions et la classification des documents protégés par le secret professionnel. Selon le sondage sur les tarifs de l'eDiscovery de l'hiver 2026, $0.26–$0.50 par document constituait la fourchette tarifaire la plus fréquemment déclarée pour l'examen assisté par IA générative parmi les répondants ayant indiqué des tarifs par document. Les modèles tarifaires varient, et les équipes juridiques doivent toujours évaluer les risques d'hallucination, l'auditabilité et les exigences de validation avant toute adoption.
- Analyses : Le regroupement par concepts, le regroupement des courriels par fil de discussion et la cartographie des communications aident les équipes à hiérarchiser les documents et à reconstituer les chronologies sans tout lire manuellement.
- Plateformes infonuagiques : Les outils d'eDiscovery natifs du cloud offrent un traitement plus rapide, une mise à l'échelle flexible et une tarification plus prévisible que les systèmes sur site. Recherchez des plateformes qui intègrent la collecte, le traitement, l'examen et la production dans un environnement unique.
- Logiciels de conservation juridique : Ils automatisent les notifications aux dépositaires, suivent les accusés de réception et créent une piste d'audit. Pour toute affaire impliquant plusieurs dépositaires, il s'agit d'un élément essentiel à la défendabilité, et non d'une simple option appréciable.
Rôles et responsabilités de l'équipe tout au long du processus
L'eDiscovery exige une coordination étroite entre les services juridiques, informatiques et opérationnels. Les lacunes dans l'attribution des responsabilités sont à l'origine des problèmes. Utilisez ce tableau pour déterminer qui dirige et qui apporte son soutien à chaque étape :
| Étape | Responsables | Soutien |
|---|---|---|
| ÉtapeIdentification / ECA | ResponsablesJuristes internes, opérations juridiques | SoutienTI, gestion des documents |
| ÉtapePréservation / conservation juridique | ResponsablesJuristes internes | SoutienOpérations juridiques, TI, assistants juridiques |
| ÉtapeCollecte | ResponsablesTI, prestataire d'eDiscovery | SoutienJuristes internes, opérations juridiques |
| ÉtapeTraitement | ResponsablesPrestataire d'eDiscovery | SoutienTI |
| ÉtapeExamen | ResponsablesAvocats externes, avocats sous contrat | SoutienOpérations juridiques, assistants juridiques |
| ÉtapeAnalyse | ResponsablesAvocats externes, opérations juridiques | SoutienPrestataire d'eDiscovery |
| ÉtapeProduction | ResponsablesAvocats externes, prestataire d'eDiscovery | SoutienOpérations juridiques, TI |
Voici quelques éléments que j'ajouterais d'après mon expérience :
- Les opérations juridiques servent souvent de couche de coordination entre les services juridiques et informatiques. Pour les affaires importantes, désigner un interlocuteur attitré pour les opérations juridiques évite les retards lors des transferts de responsabilité.
- Le service informatique n'a souvent aucune visibilité sur les activités du service juridique jusqu'à la réception d'une demande de collecte. Intégrer le service informatique à l'identification — avant tout déplacement de données — évite les interventions précipitées de dernière minute.
- Les prestataires varient considérablement en matière de périmètre. Certains fournissent un examen géré de bout en bout ; d'autres ne s'occupent que du traitement et de l'hébergement. Sachez ce que vous achetez avant le début de l'affaire.
More Articles
Facteurs de coûts du processus d'eDiscovery et moyens de les maîtriser
Le principal levier de coût de l'eDiscovery est le volume de données. Moins vous faites circuler de données dans le processus, moins vous dépensez à chaque étape ultérieure. Voici les principaux facteurs de coûts et les points sur lesquels vous pouvez agir :
- Périmètre de la collecte : Les listes étendues de dépositaires et les collectes de boîtes de réception complètes augmentent tous les coûts en aval. Une collecte ciblée — définie par une plage de dates, un type de fichier et des mots-clés — réduit le volume sans compromettre la défendabilité.
- Frais de traitement : Le traitement peut coûter environ $25–$100 par Go, selon le volume de données, les accords conclus avec le prestataire et les exigences de traitement. Selon le guide tarifaire d'eDiscovery Insider, les tarifs de traitement concurrentiels se situent généralement entre $50 et $100 par Go, tandis que les accords portant sur de gros volumes peuvent être moins chers. La déduplication et la suppression des fichiers système permettent de réduire la quantité de données à héberger et à examiner.
- Frais d'hébergement : Les frais mensuels par Go s'accumulent rapidement dans les affaires de longue durée. Négociez à l'avance une tarification forfaitaire ou tout compris, et vérifiez si la déduplication est appliquée avant le calcul des frais d'hébergement.
- Main-d'œuvre consacrée à l'examen : L'examen par les avocats et l'évaluation du secret professionnel peuvent générer des dépenses d'eDiscovery considérables, en particulier lorsque d'importants volumes de documents nécessitent un examen manuel. L'utilisation de TAR ou d'un examen initial validé assisté par IA générative peut réduire la charge de travail et aider les équipes à hiérarchiser les documents nécessitant un examen plus approfondi.
- Modifications tardives du format : Se mettre d'accord rapidement sur les spécifications de production évite de coûteuses mises en forme ultérieures. Intégrez les exigences de format à votre plan de collecte et de traitement dès le premier jour.
J'encouragerais chaque équipe à suivre les dépenses par étape et par affaire. Il est difficile de négocier de meilleurs tarifs ou de justifier un investissement technologique sans données de référence indiquant où l'argent est réellement dépensé.
Bonnes pratiques pour un flux de travail de découverte électronique défendable et reproductible
Un flux de travail défendable ne consiste pas seulement à faire les choses correctement : il s'agit aussi de pouvoir démontrer qu'elles ont été faites. Ces pratiques rendent votre processus à la fois rigoureux et documentable :
- Établissez une cartographie des données avant chaque dossier : sachez où se trouvent les ESI, qui en a le contrôle et quelles sont les politiques de conservation. Cela accélère l'identification et permet de mettre en place des mesures de conservation plus complètes.
- Mettez immédiatement en place les mesures de conservation et suivez les accusés de réception : ne vous fiez pas aux communications informelles. Utilisez un logiciel de gestion des mesures de conservation ou, au minimum, un e-mail suivi exigeant une réponse. Documentez tout.
- Définissez le périmètre de manière proportionnée : travaillez avec l'avocat afin de définir les paramètres de collecte conformément à la règle FRCP 26(b)(1). La proportionnalité est une norme reconnue : utilisez-la pour contester les demandes excessivement larges.
- Documentez chaque décision de traitement : filtres de dé-NISTage, restrictions par plage de dates, logique des termes de recherche : tout doit être consigné et conservé. Si votre processus est contesté, votre documentation constitue votre défense.
- Validez le TAR avant de clôturer l'examen : avant de vous appuyer sur le codage prédictif pour clôturer un ensemble de documents, effectuez un échantillonnage de contrôle qualité statistiquement valide afin de confirmer que le rappel et la précision respectent les seuils convenus.
- Mettez par écrit un accord sur les spécifications de production : obtenez une stipulation conjointe ou une ordonnance du tribunal couvrant le format, les champs de métadonnées et les exigences relatives au relevé des documents couverts par le secret professionnel avant de produire quoi que ce soit.
- Effectuez des bilans après chaque dossier : une fois chaque dossier clôturé, faites le point avec l'équipe. À quel moment les coûts ont-ils augmenté fortement ? Qu'est-ce qui a pris plus de temps que prévu ? Intégrez ces conclusions à votre prochain flux de travail.
Reproductible ne signifie pas rigide. Votre flux de travail doit être suffisamment documenté pour être défendable et suffisamment flexible pour s'adapter aux types de données et à la complexité de chaque dossier.
Trouvez le logiciel de découverte électronique adapté à votre flux de travail
Un flux de travail de découverte électronique défendable dépend de la disponibilité des bons outils pour gérer la conservation, la collecte, le traitement, l'examen et la production. Consultez mon guide des meilleurs logiciels de découverte électronique pour comparer les plateformes, évaluer leurs fonctionnalités et trouver une solution adaptée aux besoins de votre équipe juridique.